llms.txt einrichten: Aufbau, Ablageort & SEO-Wirkung
Wichtigste Erkenntnisse:
- ✓Die Datei kann im Website-Root oder pfadspezifisch in einem Unterverzeichnis abgelegt werden und nutzt Markdown zur Strukturierung. (The /llms.txt file)
- ✓Lighthouse bietet eine eigene Prüfung für die maschinenlesbare Zusammenfassung. (llms.txt | Lighthouse)
- ✓Google erfordert keine speziellen KI-Dateien für gute Rankings in generativen Suchen. (KI-Funktionen und Ihre Website)
Die llms.txt ist eine vorgeschlagene Markdown-Konvention, die KI-Agents eine strukturierte Übersicht über wichtige Website-Inhalte bereitstellt. Sie dient als gezielte Lesehilfe für moderne Sprachmodelle, ersetzt jedoch weder klassische SEO-Maßnahmen noch die etablierte robots.txt zur Steuerung von Suchmaschinen-Crawlern.
Unser Team testet neue technische SEO-Standards wie dieses Format direkt in der Praxis und wertet die echten Crawl-Daten aus, bevor wir sie für Kundenprojekte empfehlen.
Funktion der Datei
Wenn digitale Assistenten eine Website besuchen, suchen sie nach Kontext. Die llms.txt ist eine vorgeschlagene und zunehmend verbreitete Markdown-Konvention, die KI-Agents eine strukturierte Übersicht über wichtige Website-Inhalte bereitstellt. Sie fungiert als maschinenlesbarer Wegweiser für KI-Agents. Sie nutzt dafür Markdown, da dieses Format für Sprachmodelle und KI-Agents vergleichsweise leicht und strukturiert maschinell verarbeitbar ist.
Im Gegensatz zu HTML-Seiten, die für menschliche Besucher mit Design-Elementen angereichert sind, reduziert dieses Format den Inhalt auf das Wesentliche. Sprachmodelle müssen so keine Navigationselemente, Footer oder Werbebanner herausfiltern, was die Verarbeitung deutlich beschleunigt.
Vorteile der reduzierten Struktur
Die offizielle Spezifikation[1] sieht vor, dass die Datei kuratierte Links und klare Überschriften enthält. Wer eine professionelle KI Beratung in Anspruch nimmt, lernt schnell, dass strukturierte Daten für die maschinelle Verarbeitung entscheidend sind. Wer nach dem Standard llms txt sucht, stellt fest, dass die Reduktion auf reinen Text die Fehlerquote beim Auslesen minimiert.
Ein häufiger Fehler ist der Versuch, die gesamte Website in dieses Dokument zu kopieren. Das führt in der Praxis dazu, dass die Bots den Fokus verlieren und die wichtigsten Kernbotschaften der Domain ignorieren.
Mechanismus der Datenverarbeitung
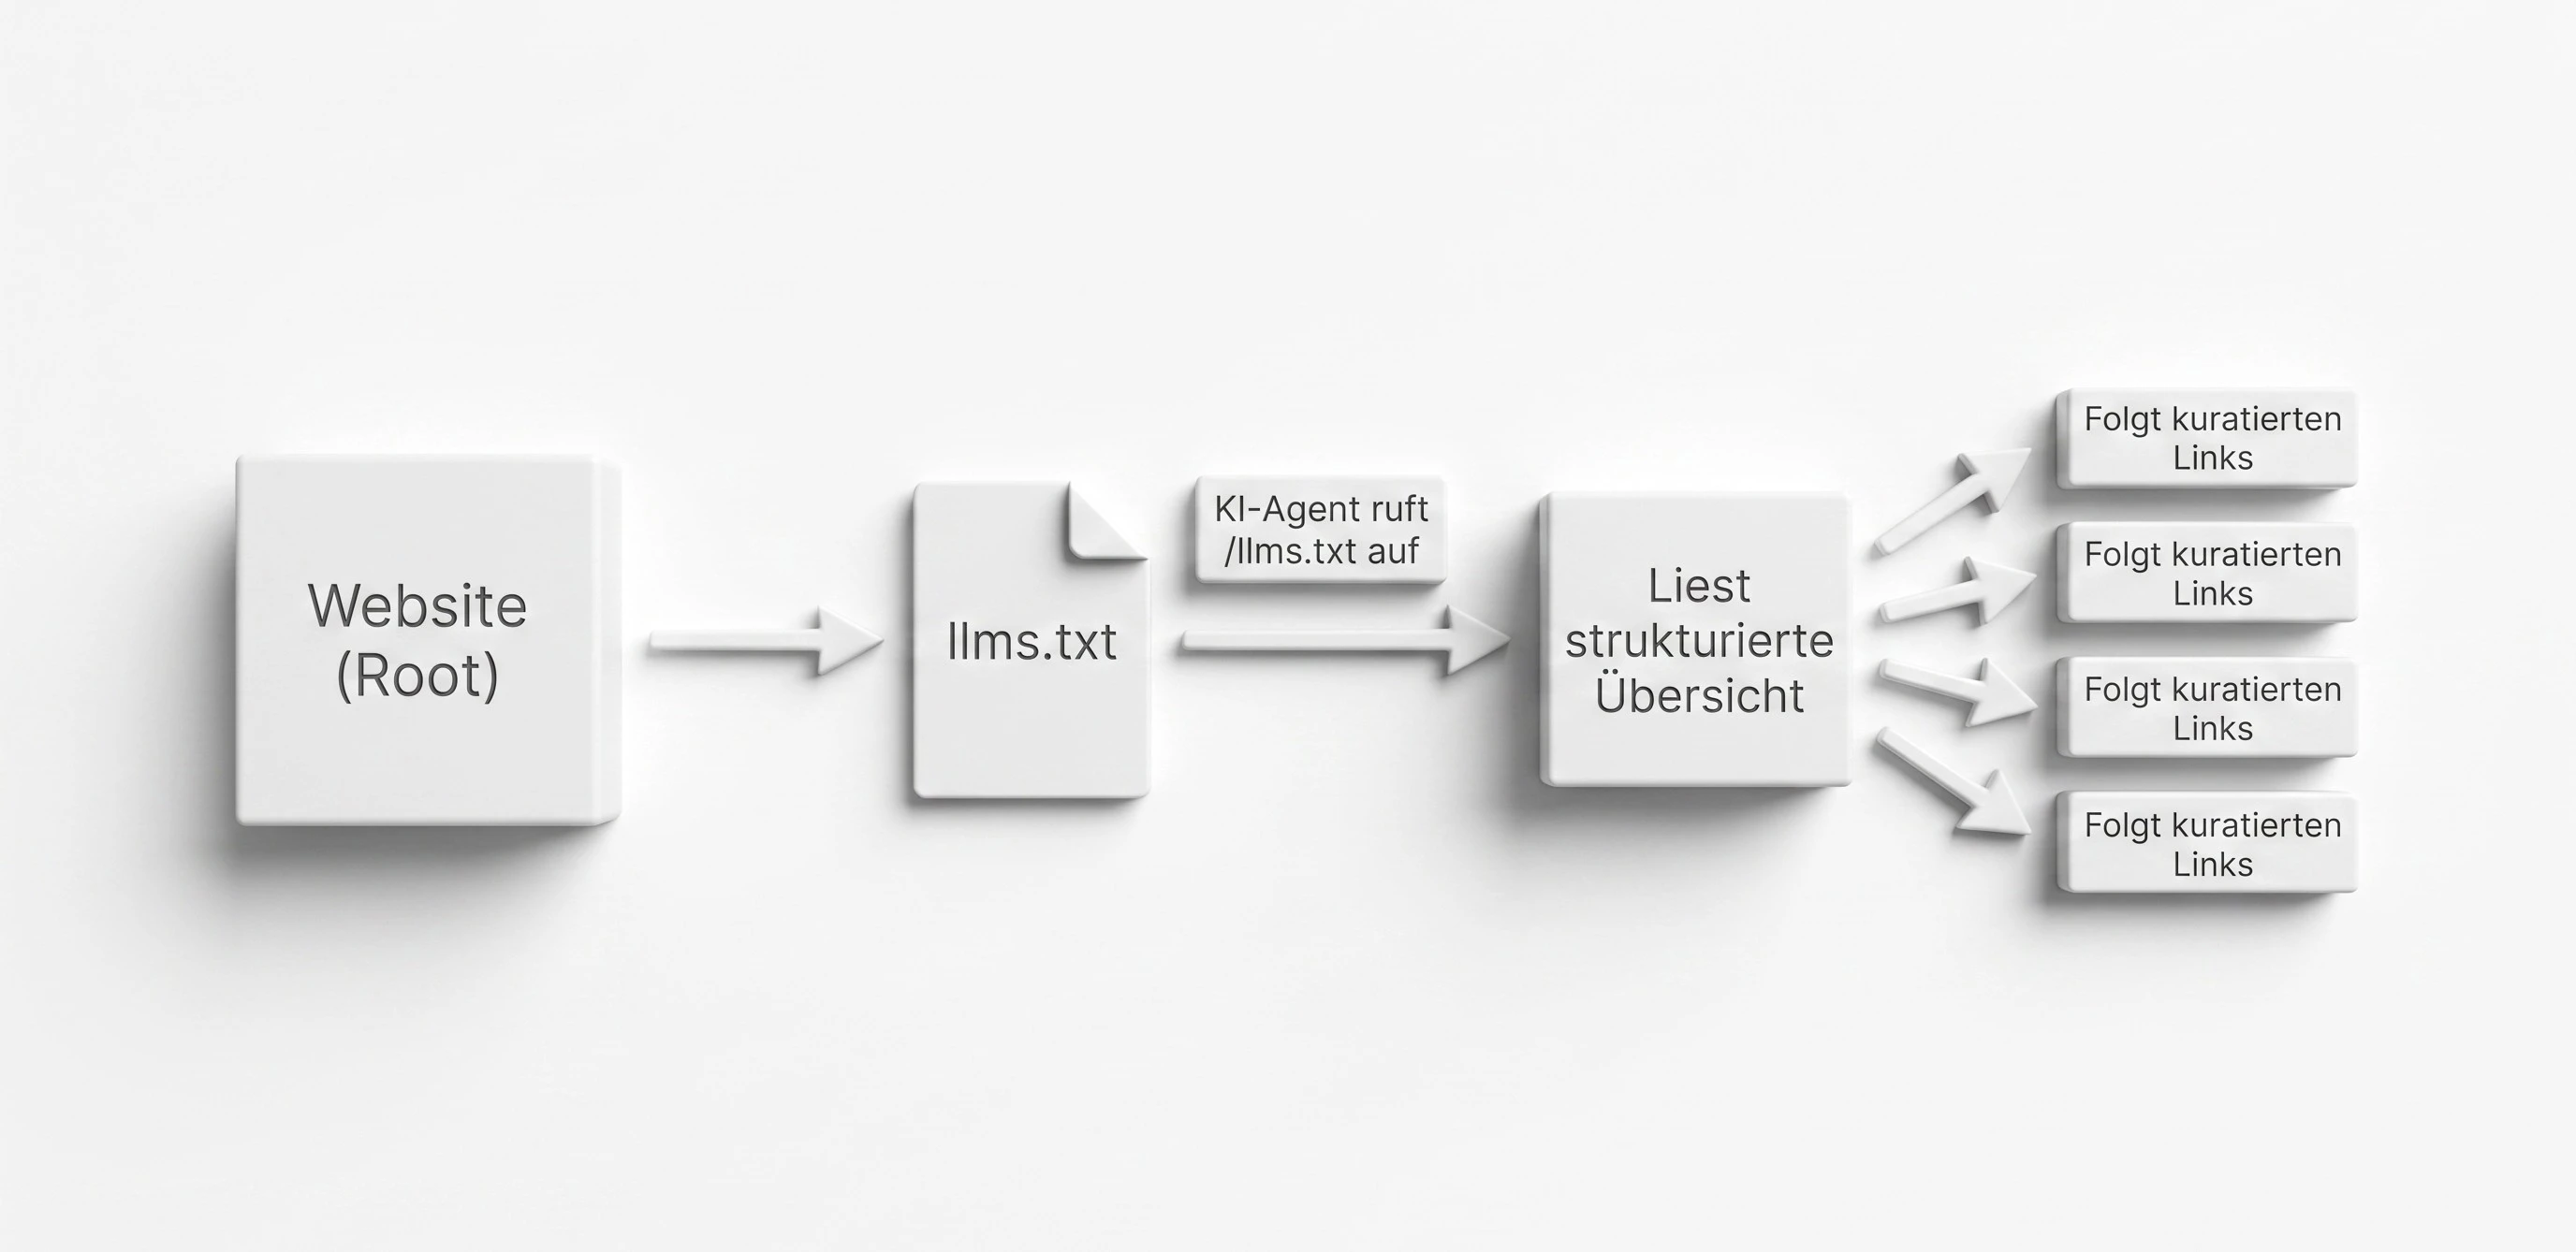
Unterstützende KI-Agents können die llms.txt als Einstiegspunkt nutzen, um relevante Inhalte einer Website gezielt zu finden. Sie können die bereitgestellten Informationen bei der Suche nach relevantem Kontext und für die Beantwortung konkreter Nutzeranfragen verwenden.
Die reduzierte Darstellung kann den Verarbeitungsaufwand und den Tokenverbrauch für KI-Agents verringern. Während ein herkömmlicher Bot das gesamte Document Object Model rendern muss, liest der Agent hier nur die essenziellen Fakten und folgt den vorgegebenen Pfaden.
Aufbau und Ablageort
Typischerweise liegt die Datei im Website-Root (dem obersten Hauptverzeichnis) unter der Adresse domain.de/llms.txt. In der ursprünglichen Version des llms.txt-Vorschlags war der Website-Root der vorgesehene Ablageort.
Wer ein llms txt example sucht, findet in der offiziellen Dokumentation[1] klare Vorgaben zur Strukturierung. Der Inhalt muss zwingend als reiner Text formatiert sein und folgt einem festen Aufbau in Markdown.
Titel und Beschreibung: Ein kurzes Intro erklärt den Zweck der Domain und das Kernthema.
Kuratierte Links: Verweise auf die wichtigsten Unterseiten, idealerweise mit kurzen Erläuterungen versehen.
Formatierung: Strikte Nutzung von Rauten für Überschriften und Bindestrichen für Listen.
Für eine zuverlässige Verarbeitung sollte die Datei in UTF-8 gespeichert werden, insbesondere wenn Umlaute oder Sonderzeichen enthalten sind.
Technische Anforderungen
Die Strukturierung durch Rauten und Sternchen hilft dem Parser, Hierarchien zu verstehen. Ein sauberes Dokument verzichtet vollständig auf HTML-Tags, Inline-Styles oder Skripte, da diese den Lesefluss der KI stören.
Ein häufiger Fehler bei der Erstellung ist die versehentliche Verwendung von absoluten Pfaden, die noch auf lokale Testumgebungen verweisen. Alle kuratierten Links sollten auf gültige und erreichbare URLs verweisen. Interne Links sollten auf die finale Produktionsumgebung zeigen; relevante externe Quellen können ebenfalls eingebunden werden. Andernfalls leiten Sie die Sprachmodelle in Sackgassen, was den gesamten Nutzen der maschinenlesbaren Zusammenfassung zunichtemacht.
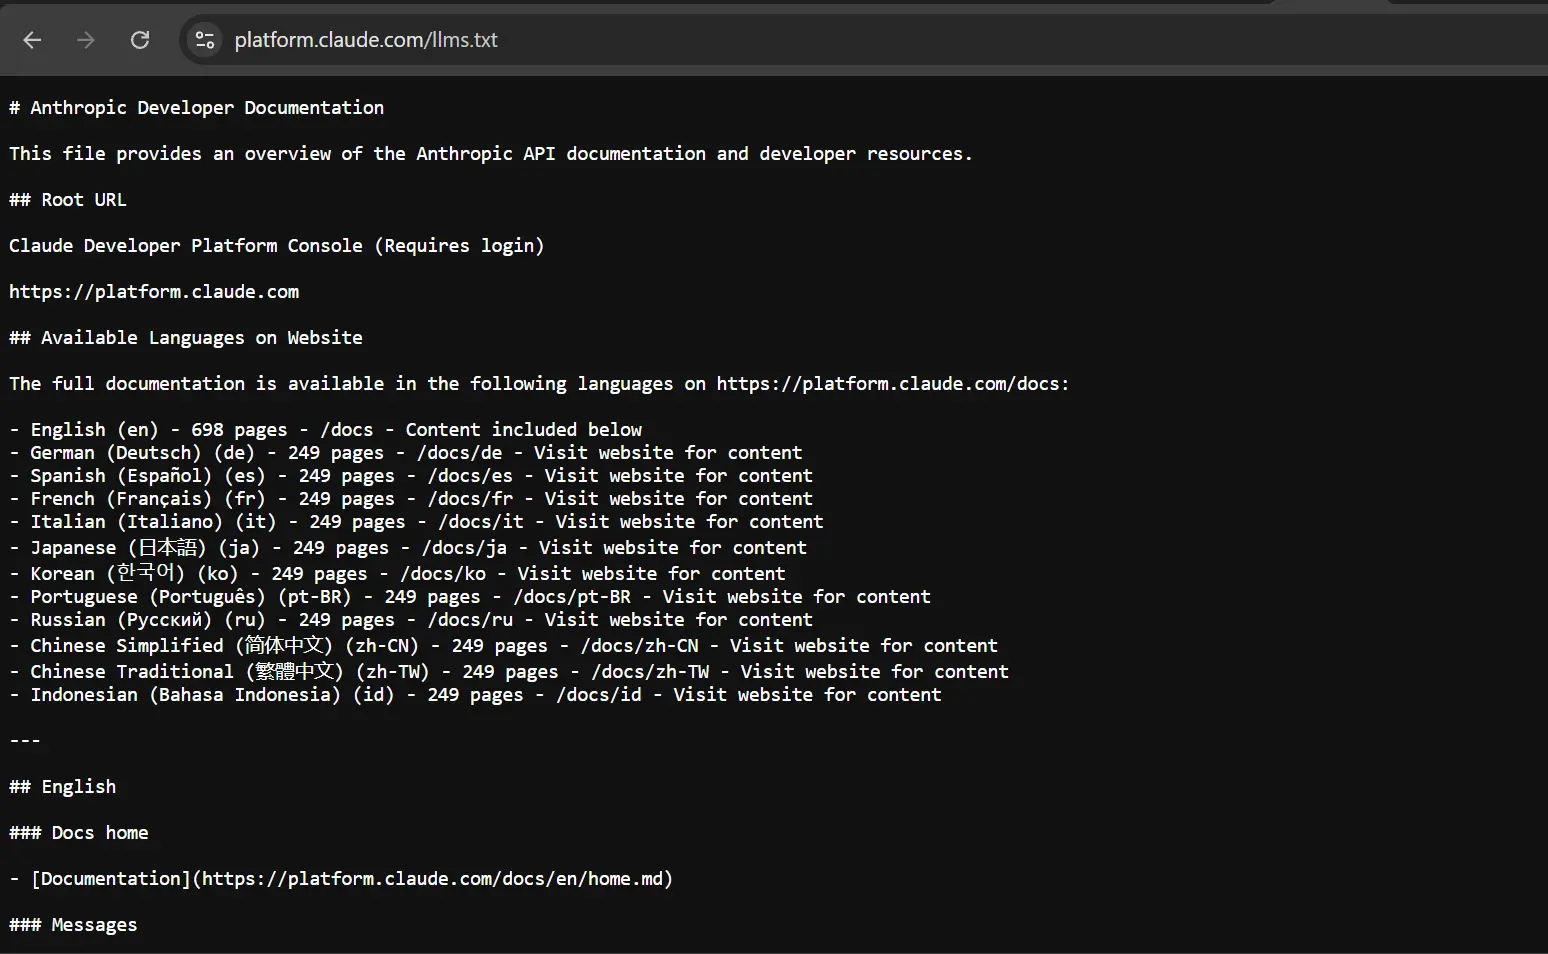
Wenn Sie die Datei anlegen, prüfen Sie die Erreichbarkeit direkt im Browser. Ein Aufruf der URL muss den reinen Text ohne jegliches Theme-Rendering des Content-Management-Systems zurückgeben.
llms.txt v2: Pfadspezifische Dateien und Discovery
Die aktuelle Version der llms.txt-Spezifikation erlaubt nicht nur eine zentrale /llms.txt im Website-Root, sondern auch pfadspezifische Dateien wie /docs/llms.txt. Eine solche Datei beschreibt die Inhalte unter dem jeweiligen Pfad. Zusätzlich können Websites mit rel="describedby" auf die zuständige llms.txt und mit rel="alternate" type="text/markdown" auf eine Markdown-Version einer einzelnen Seite hinweisen.
Abgrenzung zur robots.txt
Die robots.txt ist ein striktes Regelwerk, das klassischen Crawlern verbietet oder erlaubt, bestimmte URLs abzurufen. Das neue Format liefert hingegen gezielten inhaltlichen Kontext für LLMs (Large Language Models). Während die eine Datei den technischen Zugang steuert, fasst die andere das Wissen der Website strukturiert zusammen.
Für eine ganzheitliche SEO-Strategie erfüllen beide Dokumente völlig unterschiedliche Aufgaben. Ein Disallow-Eintrag in der robots.txt weist unterstützte Crawler an, bestimmte Bereiche nicht abzurufen, während llms.txt lediglich zusätzlichen inhaltlichen Kontext bereitstellt.
Der direkte Vergleich zeigt, wie sich die Einsatzgebiete der verschiedenen Standards voneinander abgrenzen.
| Dateityp | Hauptzweck | Zielgruppe | Format |
|---|---|---|---|
| robots.txt | Crawl-Steuerung | Klassische Suchmaschinen-Bots | Text mit Allow/Disallow-Direktiven |
| sitemap.xml | Vollständige URL-Auflistung zur Indexierung | Suchmaschinen-Crawler | XML-Struktur mit Metadaten |
| llms.txt | Inhaltliche Zusammenfassung und Kontext | KI-Agents und Sprachmodelle | Markdown-Text mit kuratierten Links[1] |
| humans.txt | Nennung der Entwickler und Autoren | Menschliche Besucher | Reiner Klartext ohne feste Syntax |
Die Tabelle verdeutlicht, dass die inhaltliche Zusammenfassung die etablierten Steuerdateien ergänzt, aber niemals ersetzt.
Ein typischer Stolperstein ist die Annahme, man könne KI-Bots über das neue Format aussperren. Da es keine Disallow-Befehle unterstützt, ist dies nicht möglich. Unerwünschte unterstützte Crawler lassen sich über entsprechende robots.txt-Regeln vom Crawling bestimmter Bereiche ausschließen. Für einen tatsächlichen Zugriffsschutz sind jedoch serverseitige Maßnahmen erforderlich.
Ob Sie beide Dateien benötigen, hängt von Ihrer Zielgruppe ab. Wenn Ihre Inhalte häufig als Quelle für maschinelle Antworten dienen sollen, lohnt sich die zusätzliche Bereitstellung der inhaltlichen Zusammenfassung.
Datei auf Fehler prüfen
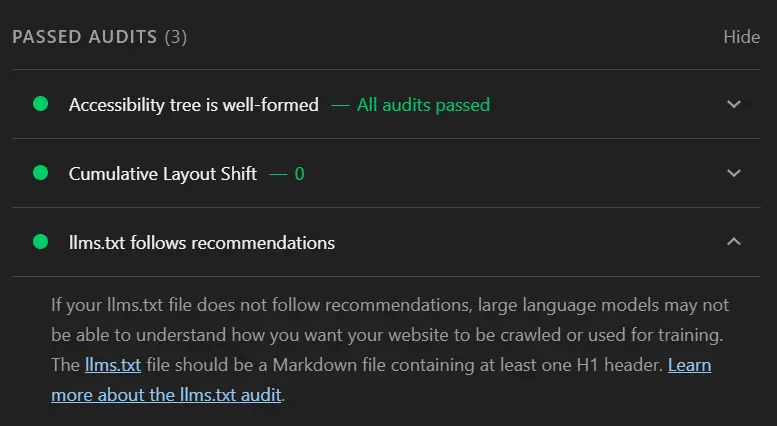
Nach der Erstellung muss die maschinenlesbare Zusammenfassung validiert werden. Google Lighthouse bietet im Bereich „Agentic Browsing“ eine technische Prüfung für llms.txt und kann kontrollieren, ob die Datei erreichbar ist und grundlegenden Empfehlungen folgt. Die Prüfung bestätigt vor allem die technische Bereitstellung der Datei; sie zeigt nicht, ob oder wie einzelne KI-Systeme die Inhalte tatsächlich nutzen oder interpretieren.
Die Chrome-Dokumentation[2] führt diese Kontrolle unter der Kategorie Agentic Browsing auf. So stellen Sie sicher, dass die Informationen für maschinelle Leser zugänglich sind.
Entwicklertools öffnen: Starten Sie den Chrome-Browser und rufen Sie Ihre Website auf.
Lighthouse starten: Navigieren Sie zum entsprechenden Tab in den DevTools.
Kategorie wählen: Aktivieren Sie die Prüfung für Agentic Browsing.
Report analysieren: Prüfen Sie, ob das Tool die Datei am vorgesehenen Ablageort (Root oder Unterverzeichnis) erfolgreich erkennt.
Manuelle Kontrolle und Fallstricke
Zusätzlich zur reinen Erreichbarkeit sollten Sie den Inhalt manuell in einem Markdown-Editor prüfen. Oft schleichen sich unsichtbare Formatierungsfehler ein, wie etwa fehlende Leerzeichen nach den Rauten der Überschriften. Solche syntaktischen Ungenauigkeiten führen dazu, dass die Parser der Sprachmodelle die Hierarchie der Informationen nicht mehr korrekt auflösen können. Ein kurzer Testlauf in einer sicheren lokalen Umgebung verhindert diese strukturellen Ausfälle zuverlässig.
Ein verbreitetes Missverständnis ist, dass ein grüner Haken im Tool automatisch gute Rankings garantiert. Die Prüfung bestätigt lediglich die technische Erreichbarkeit, bewertet aber weder die inhaltliche Qualität noch die Relevanz der hinterlegten Links.
Die Validierung achtet streng auf den HTTP-Statuscode. Nur wenn der Server eine saubere 200-OK-Antwort ohne Weiterleitungsketten liefert, gilt die Bereitstellung als erfolgreich abgeschlossen.
Entwickler sollten diese Prüfung nach jedem Deployment wiederholen. Besonders bei System-Updates oder Server-Umzügen gehen statische Textdateien schnell verloren, was die maschinelle Lesbarkeit sofort unterbricht.
SEO-Wirkung in der Praxis
Der Nutzen für die Google Search wird oft überschätzt. Aktuell gibt es keine Garantie, dass die Datei zu mehr Sichtbarkeit führt oder die Häufigkeit von KI-Zitaten (Quellenangaben in generierten Antworten) steigert. Die Suchmaschine verarbeitet Inhalte auch ohne dieses Format problemlos.
Eine groß angelegte Branchenanalyse[4] untersuchte die Verbreitung und fand bislang keine klaren Belege dafür, dass die Datei die Nennung in maschinellen Antworten direkt erhöht. Auch die offizielle Dokumentation[3] bestätigt, dass Websites keine speziellen Formate, kein neues Markup und keine besonderen strukturierten Daten benötigen, um in generativen Suchen aufzutauchen.
Im Vergleich zu einer fundierten OnPage-Optimierung ist der Hebel hier minimal. Während schnelle Ladezeiten und exzellente Inhalte sofort messbare Ergebnisse liefern, bleibt die Textdatei eine ergänzende, noch nicht universell unterstützte Ressource für KI-Agents.
Welche Rolle spielt llms.txt bei Google und KI-Systemen?
Google Search benötigt keine llms.txt und verwendet sie nicht als spezielles Ranking- oder Sichtbarkeitssignal. Für andere KI-Agents und agentenbasierte Systeme kann die Datei dagegen als zusätzliche Orientierung und kuratierter Einstiegspunkt dienen. Deshalb sollte llms.txt derzeit als ergänzende, noch nicht universell unterstützte Konvention verstanden werden – nicht als Voraussetzung für SEO oder GEO.
Grenzen der Automatisierung
In der Praxis zeigt sich, dass ein automatisiertes Tool oft minderwertige Ergebnisse liefert. Wer einen llms txt generator nutzt, erhält meist nur eine unkuratierte Linkliste, die dem Sprachmodell keinen echten inhaltlichen Mehrwert bietet.
Ein weiterer limitierender Faktor ist die Aktualität der Daten. Wenn Sie Ihre Website häufig überarbeiten, sollte die Textdatei möglichst synchron gehalten werden. Veraltete Informationen können dazu führen, dass KI-Agents bei einer Anfrage nicht mehr aktuelle Angaben verwenden oder weitergeben. Dieser Reputationsschaden wiegt oft schwerer als ein fehlendes Ranking in den organischen Suchergebnissen.
Die Entscheidung für oder gegen die Umsetzung sollte stets von Ihren verfügbaren Ressourcen abhängen. Wenn die technischen Grundlagen Ihrer Domain bereits perfekt sind, ist die Anlage eine sinnvolle Vorbereitung auf kommende Entwicklungen im Bereich der künstlichen Intelligenz.
Einbindung in WordPress
Die Integration in ein CMS erfordert etwas Vorbereitung. In WordPress kann die llms.txt manuell bereitgestellt oder über ein Plugin dynamisch generiert werden. Je nach Anwendungsfall kann sie im Website-Root oder in einem passenden Unterverzeichnis liegen. Wichtig ist dabei, dass die finale Ausgabe reines Markdown bleibt und keine Theme-Elemente enthält.
Wer professionelle SEO Tools nutzt, kann die Ausgabe oft direkt über die bestehende Infrastruktur steuern, ohne manuell in die Serverstruktur eingreifen zu müssen.
Die folgende Übersicht zeigt, wie typische Website-Elemente in das maschinenlesbare Format übersetzt werden müssen.
| WordPress-Inhalt | Markdown-Äquivalent | Relevanz für KI |
|---|---|---|
| H1-Seitentitel | Einzelne Raute (# Titel) | Sehr hoch, definiert das Hauptthema |
| H2-Zwischenüberschriften | Zwei Rauten (## Unterthema) | Hoch, strukturiert den Kontext |
| Aufzählungen | Bindestrich (- Element) | Mittel, bündelt Fakten |
| Interne Verlinkungen | Klammer-Syntax ([Text](URL)) | Sehr hoch, leitet den Crawler weiter |
Die Übersetzung verdeutlicht, dass visuelle Elemente wie Bilder oder Buttons in der Textversion vollständig entfallen und nur die reine Information übrig bleibt.
Das führt oft dazu, dass dynamische Generatoren fehlerhafte Pfade ausgeben, wenn sie Caching-Systeme nicht korrekt berücksichtigen. Ein häufiger Fehler ist, dass das Caching-Plugin die Textdatei wie eine normale HTML-Seite behandelt und Skripte am Ende der Datei anhängt. Schließen Sie die URL /llms.txt daher zwingend in den Einstellungen Ihres Caching-Plugins von der Optimierung aus. Prüfen Sie anschließend im Inkognito-Modus, ob die URL weiterhin reinen Text ohne störende HTML-Fragmente ausliefert.
Wenn sich Inhalte häufig ändern, ist eine automatisch aktualisierte oder dynamisch generierte llms.txt in der Regel sinnvoller als eine manuell gepflegte Datei. Bei statischen Unternehmensseiten reicht hingegen der einmalige manuelle Upload völlig aus. Achten Sie beim manuellen Upload darauf, die Datei im UTF-8-Format zu speichern, um Darstellungsprobleme bei Umlauten zu vermeiden.
Fazit
Die technische Einrichtung der Datei ist in wenigen Minuten erledigt, doch ein belastbarer Wirkungsnachweis für bessere Rankings fehlt bislang. Da große Suchmaschinen Inhalte auch ohne dieses Format problemlos verarbeiten, bleibt die Textdatei eine risikoarme Vorbereitung auf künftige Entwicklungen. Sie ergänzt eine solide Strategie, kann aber fehlende technische Grundlagen niemals kompensieren.
Autorenfazit
In meiner täglichen Arbeit mit Kundenprojekten sehe ich oft den Drang, jeden neuen Trend sofort umzusetzen. Mein Rat: Wenn Ihre Website bereits technisch perfekt aufgestellt ist und Sie freie Entwickler-Ressourcen haben, lohnt sich die Anlage als Vorbereitung auf künftige KI-Crawler durchaus. Der Aufwand ist minimal und schadet nicht.
Für die allermeisten Projekte gilt jedoch eine andere Priorität. Solange Ihre Core Web Vitals (die Metriken zur Ladezeit und Nutzererfahrung) nicht im grünen Bereich sind und die Informationsarchitektur Lücken aufweist, sollten Sie Ihre Zeit nicht in experimentelle Textdateien investieren. Konzentrieren Sie sich zuerst auf die Hausaufgaben, die heute schon messbar Umsatz bringen.
Bereit für den nächsten Schritt?
Da die Textdatei allein noch keinen belegten Sichtbarkeitsgewinn bringt, lohnt es sich, das Budget zuerst dort einzusetzen, wo der Effekt nachweisbar ist. Eine fehlerfreie technische Basis entscheidet heute darüber, ob Ihre Inhalte überhaupt von Suchmaschinen indexiert und gerankt werden.
Als erfahrene SEO-Agentur sorgen wir dafür, dass die Grundlagen Ihrer Website stimmen. Wir optimieren Ladezeiten, beheben Crawling-Fehler und strukturieren Ihre Daten so, dass sowohl menschliche Nutzer als auch Maschinen sie perfekt verstehen. Erst wenn dieses Fundament steht, integrieren wir experimentelle Formate sinnvoll in Ihre Gesamtstrategie. SEO-Basis-Check anfragen →